真实操作案例办公文档处理
提取 PDF 内容:Tokeny 实操案例
读取本地演示发票 PDF,提取文字和明细表成 CSV、Markdown,核对数量乘单价及总额。不要将 OCR 推测当作已确认金额。
作者:Tokeny 团队 · Windows · Tokeny 1.7.8 · gpt-6-sol
准备这次任务的输入
在 Tokeny 中新建工作空间,将下载的样例解压到工作空间,选择支持工具调用的模型。本例使用合成演示数据或文中列出的公开资料。
- invoice.pdf
把任务交给 Tokeny
读取本地演示发票 PDF,提取文字和明细表成 CSV、Markdown,核对数量乘单价及总额。不要将 OCR 推测当作已确认金额。

交付文件:invoice.csv、extracted.md。
验收要点:
- 提取 3 条明细
- 总金额 380 元
- 保留来源页码
这是使用合成演示输入或指定公开资料的真实操作案例。请先读取工作空间输入,再实际生成文件并自检。所有写入、脚本与临时服务限于当前工作空间;临时服务只监听 127.0.0.1,执行后关闭;不触达外部收件人、不发布、不付款、不更改系统设置,不调用子智能体。需要公开资料时可读取给定 URL。只启用完成任务必需的工具。另写 report.md(中文)和 report.en.md(英文),简洁、完整,包含输入、处理步骤、真实结果、检查方式和局限;失败或未验证部分如实记录,不能宣称成功。最终回复用中文列出产物、关键结果与待核实项。
排版检查:Word 主标题仅出现一次,标题为黑色且与后续正文或表格保持同页;Excel 表头和长文字不能被窄列截断,合理设置列宽、换行、行高;HTML 在 390px 视口不能整页横向溢出。报告没有固定字数要求,不要为字数反复改写。
本次使用独立演示工作空间。复现时,请根据自己的文件与权限设置检查操作,确认后继续。
实际执行过程
任务从 Tokeny 输入框提交,由在线模型读取资料并调用工具实际执行。使用合成发票样例,检查提取的明细与总金额。
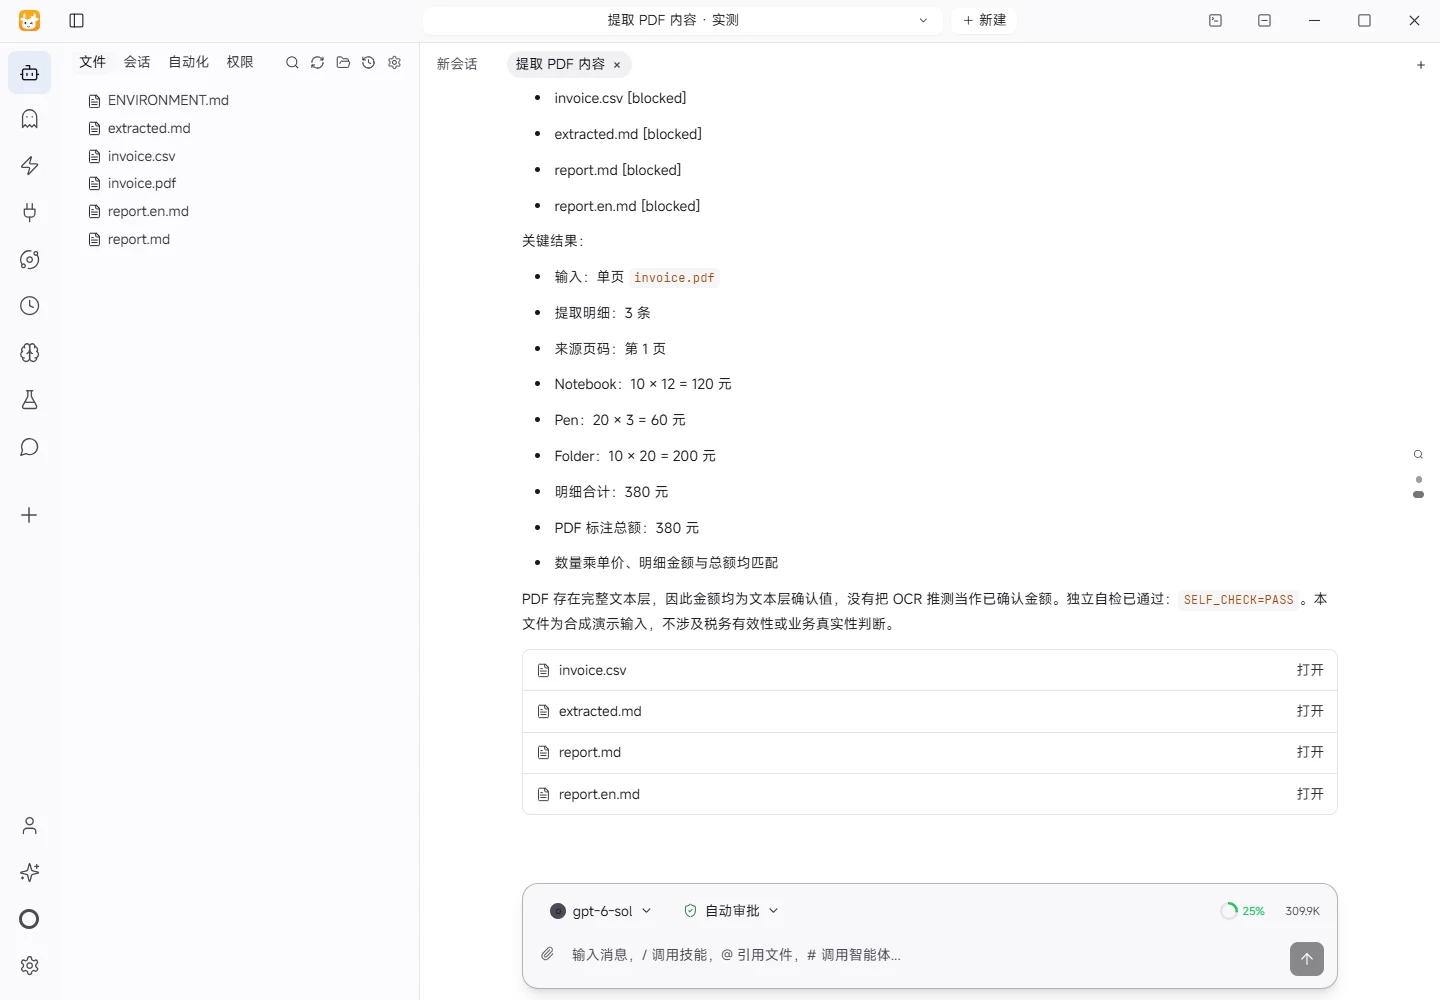
产物、结果与复核
输入
读取工作空间中的 invoice.pdf。文件为单页合成演示发票,文档自身注明“Not a tax document”和“Synthetic input for Tokeny scenario testing”。
处理步骤
- 使用
pypdf读取 PDF 页数和每页文本层。 - 确认第 1 页存在完整、可复制的发票文本,因此未将 OCR 推测作为金额依据。
- 解析 3 条明细的项目、数量、单价和金额,并记录来源页码。
- 计算每条明细的“数量 × 单价”,再将明细计算金额相加。
- 将结果写入
invoice.csv和extracted.md,并复核输出内容。
真实结果
- 提取明细:3 条。
- Notebook:10 × 12.00 = 120.00 元,匹配原文金额。
- Pen:20 × 3.00 = 60.00 元,匹配原文金额。
- Folder:10 × 20.00 = 200.00 元,匹配原文金额。
- 明细合计:380.00 元。
- PDF 文本中的总额:380.00 元。
- 结果:明细合计与 PDF 总额一致,来源均为第 1 页文本层。
检查方式
逐行检查数量、单价和提取金额;用十进制金额计算 quantity × unit_price,并检查三条计算金额之和是否等于文本中的 Total: CNY 380.00。同时确认 CSV 含 3 条明细、总额行和 source_page 字段。
局限
该 PDF 是合成演示输入,不是税务文件;本次不判断税务有效性、业务真实性或币种换算。由于文本层已完整提取,未发生 OCR 金额推测,也没有未验证的金额项。
下载产物,自己核对
压缩包保存本次执行生成的文件。替换成自己的资料后,可以按下面的检查点验收。
- 提取 3 条明细
- 总金额 380 元
- 保留来源页码
invoice.csv · 1 KBextracted.md · 2 KBreport.md · 1 KBreport.en.md · 2 KB
下载本次实际产物