真实操作案例办公文档处理
PDF 合并与拆分:Tokeny 实操案例
将输入的两份 PDF 按 A 后 B 顺序合并,再把合并结果拆成第 1–2 页和第 3–4 页,核对页数与各页文字。
作者:Tokeny 团队 · Windows · Tokeny 1.7.8 · gpt-6-sol
准备这次任务的输入
在 Tokeny 中新建工作空间,将下载的样例解压到工作空间,选择支持工具调用的模型。本例使用合成演示数据或文中列出的公开资料。
- a.pdf
- b.pdf
把任务交给 Tokeny
将输入的两份 PDF 按 A 后 B 顺序合并,再把合并结果拆成第 1–2 页和第 3–4 页,核对页数与各页文字。

交付文件:merged.pdf、pages-1-2.pdf、pages-3-4.pdf、pages.json。
验收要点:
- 合并 4 页、拆分各 2 页
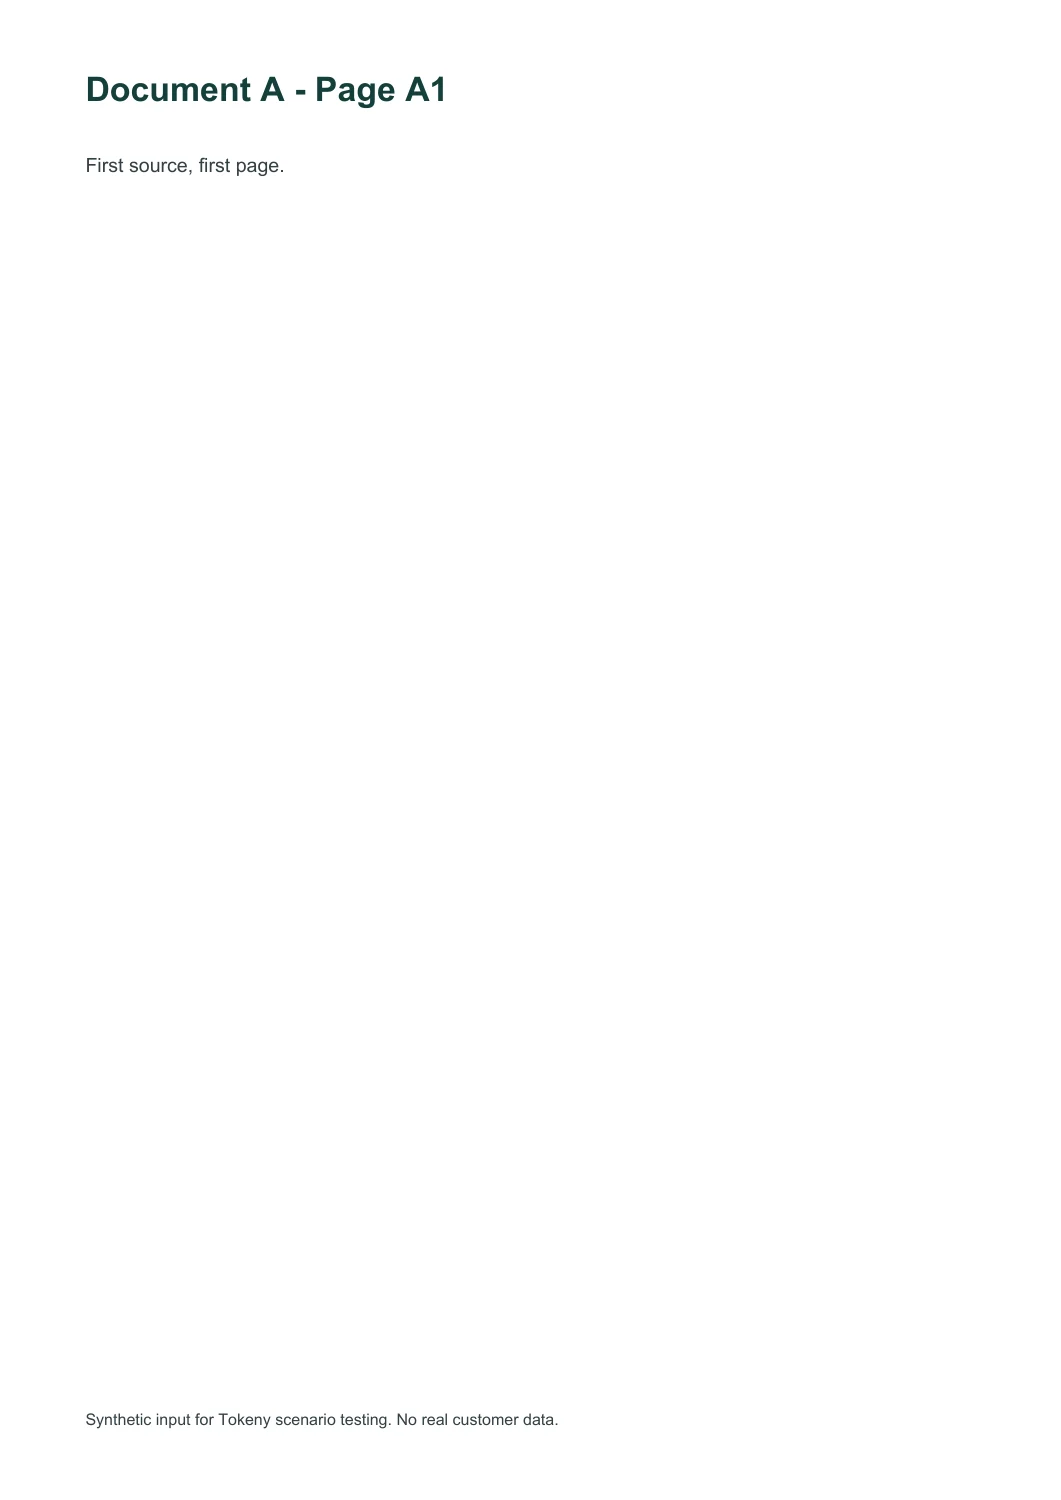
- 页序为 A1 A2 B1 B2
这是使用合成演示输入或指定公开资料的真实操作案例。请先读取工作空间输入,再实际生成文件并自检。所有写入、脚本与临时服务限于当前工作空间;临时服务只监听 127.0.0.1,执行后关闭;不触达外部收件人、不发布、不付款、不更改系统设置,不调用子智能体。需要公开资料时可读取给定 URL。只启用完成任务必需的工具。另写 report.md(中文)和 report.en.md(英文),简洁、完整,包含输入、处理步骤、真实结果、检查方式和局限;失败或未验证部分如实记录,不能宣称成功。最终回复用中文列出产物、关键结果与待核实项。
排版检查:Word 主标题仅出现一次,标题为黑色且与后续正文或表格保持同页;Excel 表头和长文字不能被窄列截断,合理设置列宽、换行、行高;HTML 在 390px 视口不能整页横向溢出。报告没有固定字数要求,不要为字数反复改写。
本次使用独立演示工作空间。复现时,请根据自己的文件与权限设置检查操作,确认后继续。
实际执行过程
任务从 Tokeny 输入框提交,由在线模型读取资料并调用工具实际执行。使用四页合成 PDF,检查实际合并、拆分页数和页序。
产物、结果与复核
输入
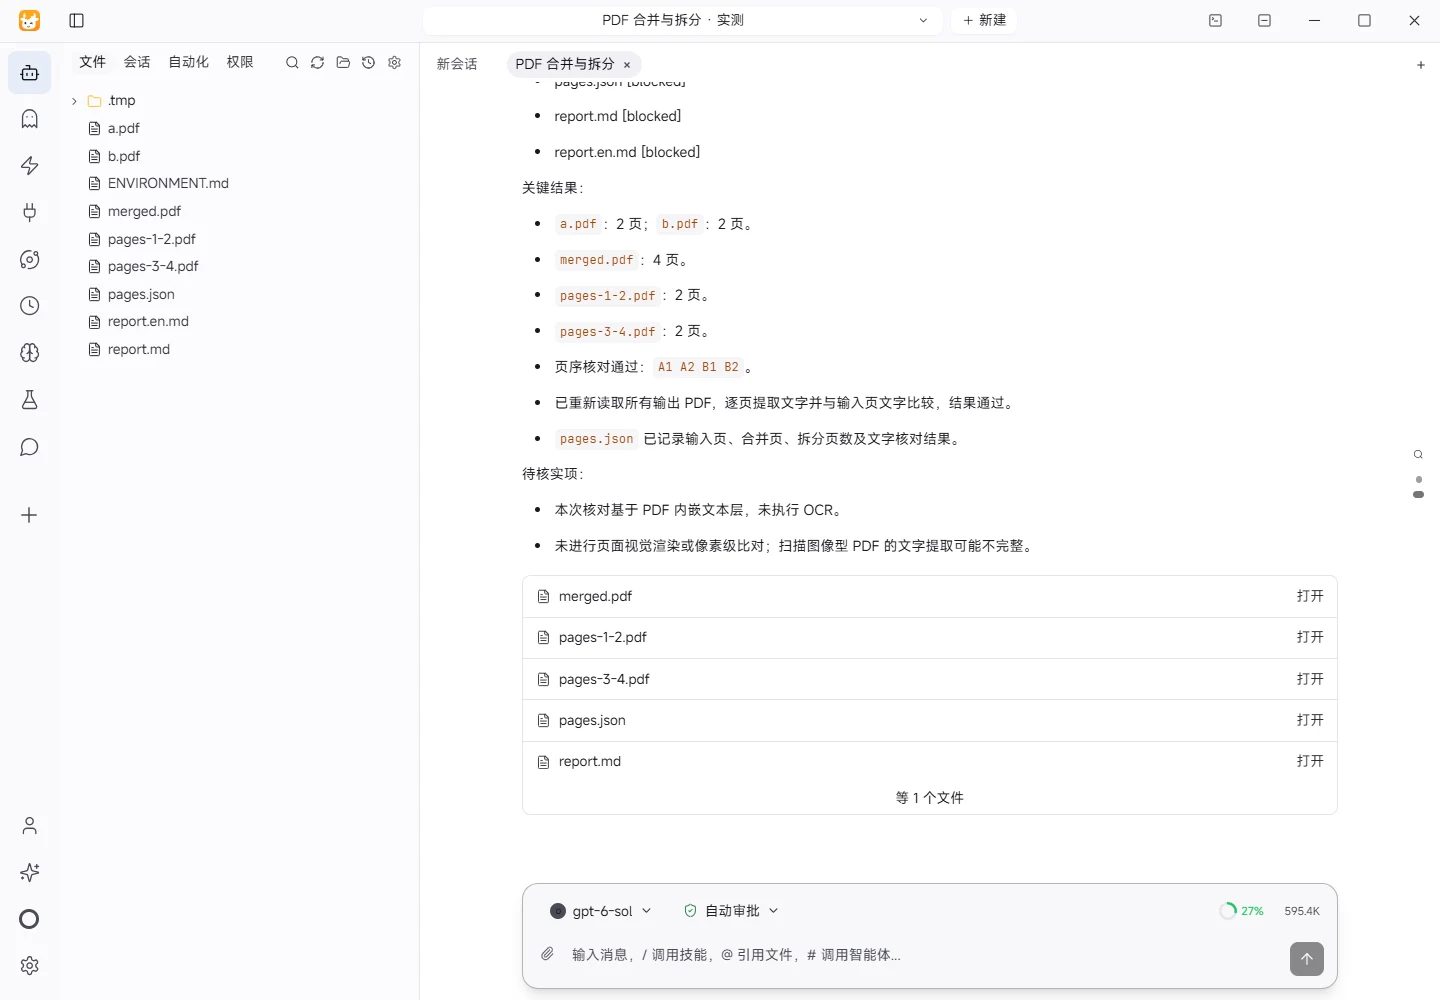
a.pdf:2 页b.pdf:2 页
处理步骤
- 读取并提取两份输入 PDF 的每页文字。
- 按 A 后 B 的顺序合并为
merged.pdf。 - 从合并结果提取第 1–2 页为
pages-1-2.pdf,第 3–4 页为pages-3-4.pdf。 - 将输入页文字、合并页文字、页数和顺序检查写入
pages.json。
真实结果
- 合并文件:
merged.pdf,4 页。 - 第一拆分文件:
pages-1-2.pdf,2 页。 - 第二拆分文件:
pages-3-4.pdf,2 页。 - 合并顺序核对:通过;目标顺序为 A1 A2 B1 B2。
检查方式
- 使用
pypdf重新打开每个输出 PDF 并统计页数。 - 使用
pypdf逐页提取文字,与输入页文字序列逐项比较。 - 详细逐页文字记录见
pages.json。
局限
文字核对依赖 PDF 内嵌文本层;若页面是扫描图像,提取文字可能为空或不完整。本次不进行 OCR,也未对页面视觉渲染结果进行像素级比对。
下载产物,自己核对
压缩包保存本次执行生成的文件。替换成自己的资料后,可以按下面的检查点验收。
- 合并 4 页、拆分各 2 页
- 页序为 A1 A2 B1 B2
merged.pdf · 3 KBpages-1-2.pdf · 2 KBpages-3-4.pdf · 2 KBpages.json · 2 KBreport.md · 1 KBreport.en.md · 1 KB
下载本次实际产物