用户调研数据分析:Tokeny 实操案例
分析 12 份合成问卷,统计满意度和功能偏好分布,按角色做交叉分析,用离线 HTML 展示图表并写结论。
作者:Tokeny 团队 · Windows · Tokeny 1.7.8 · gpt-6-sol
准备这次任务的输入
在 Tokeny 中新建工作空间,将下载的样例解压到工作空间,选择支持工具调用的模型。本例使用合成演示数据或文中列出的公开资料。
- survey.csv
把任务交给 Tokeny
分析 12 份合成问卷,统计满意度和功能偏好分布,按角色做交叉分析,用离线 HTML 展示图表并写结论。

交付文件:survey.html、analysis.csv。
验收要点:
- 样本量 12
- 均值 3.75
- 明确小样本不能代表总体
这是使用合成演示输入或指定公开资料的真实操作案例。请先读取工作空间输入,再实际生成文件并自检。所有写入、脚本与临时服务限于当前工作空间;临时服务只监听 127.0.0.1,执行后关闭;不触达外部收件人、不发布、不付款、不更改系统设置,不调用子智能体。需要公开资料时可读取给定 URL。只启用完成任务必需的工具。另写 report.md(中文)和 report.en.md(英文),每份 400–800 字,包含输入、处理步骤、真实结果、检查方式和局限;失败或未验证部分如实记录,不能宣称成功。最终回复用中文列出产物、关键结果与待核实项。
本次使用独立演示工作空间。复现时,请根据自己的文件与权限设置检查操作,确认后继续。
实际执行过程
任务从 Tokeny 输入框提交,由在线模型读取资料并调用工具实际执行。本例核对本地演示任务与实际生成的文件,结果和检查方法见下文。
产物、结果与复核
输入
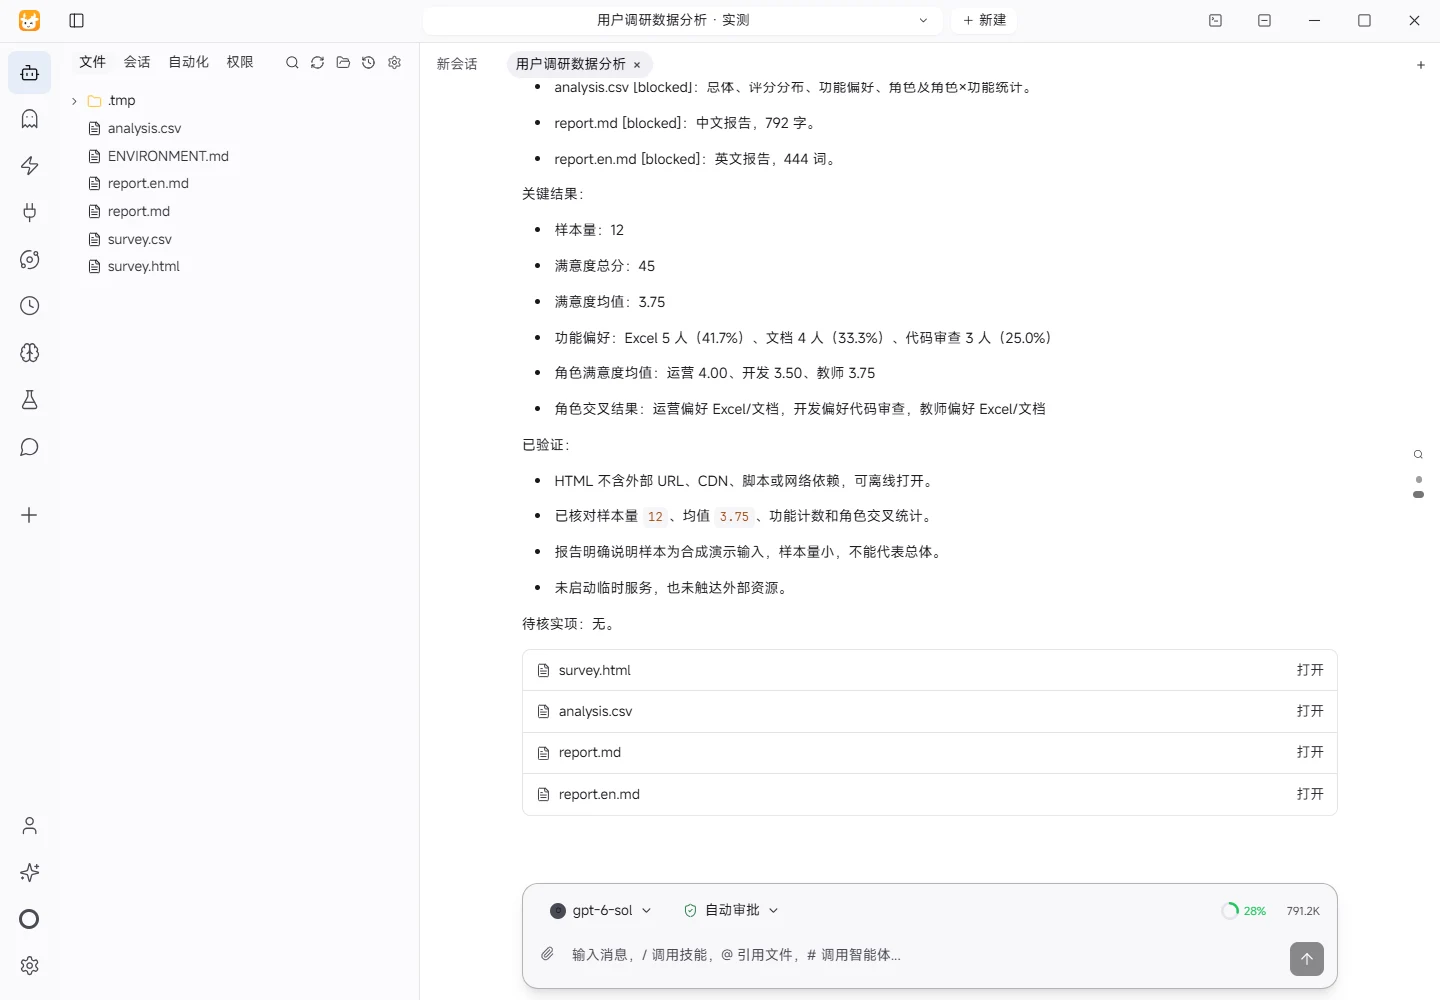
读取 survey.csv。文件包含 12 条合成问卷记录,字段为编号、角色、满意度(1–5)、偏好功能和每周使用时长。有效样本量核对为 12,角色包括运营、开发、教师,各 4 人。该数据是合成演示输入,不是现实世界抽样调查。
处理步骤
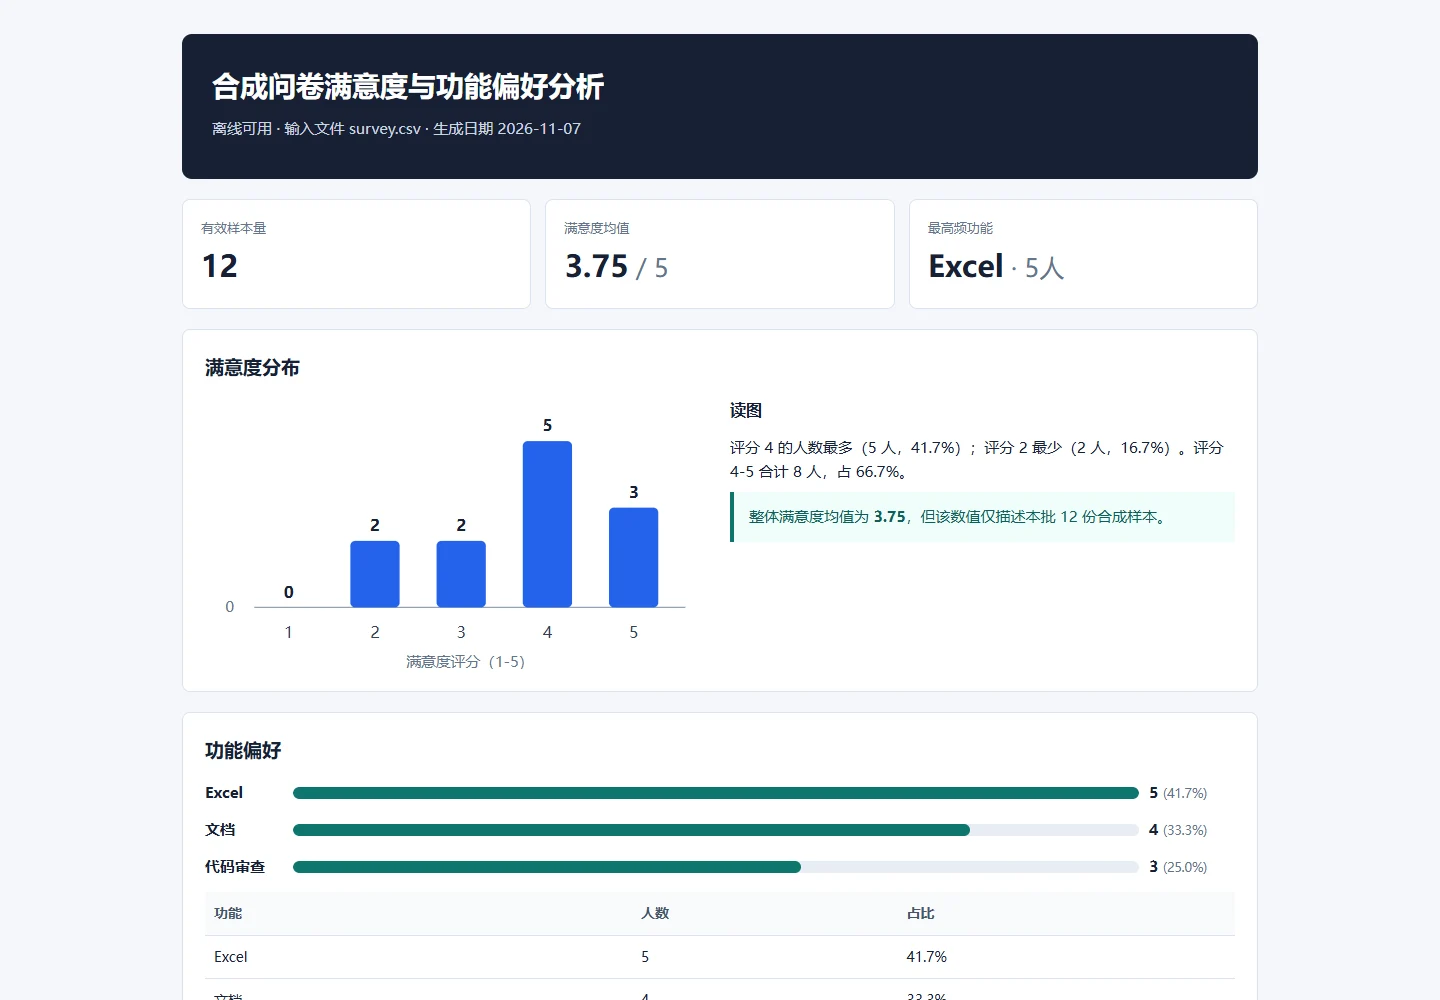
使用本地 Python 脚本读取 CSV,并将满意度与每周时长转换为数值。随后计算总体样本量、满意度算术均值、1–5 分的频数和占比、功能偏好频数和占比;再按角色计算样本量、满意度均值,并统计角色与功能偏好的交叉频数及行内占比。结果写入 analysis.csv,图表和结论写入无外部依赖的离线 survey.html。
真实结果
12 份记录的满意度总分为 45,均值为 3.75。评分 4 出现 5 次,是最多的单一评分;评分 2 出现 2 次,评分 1 未出现。功能偏好方面,Excel 5 人(41.7%),文档 4 人(33.3%),代码审查 3 人(25.0%)。按角色看,运营 4 人,满意度均值 4.00,偏好为 Excel 2、文档 2;开发 4 人,均值 3.50,偏好为代码审查 3、Excel 1、文档 0;教师 4 人,均值 3.75,偏好为 Excel 2、文档 2。运营均值最高,开发最低,但角色样本都只有 4 人。
检查方式
脚本在生成时断言输入行数为 12,并从原始 CSV 重新计算所有指标;生成后检查 analysis.csv 的样本量、均值、分母和占比,检查 HTML 是否包含 12、3.75、功能名称、角色交叉表及小样本警示。页面为纯 HTML/CSS/SVG,没有 CDN、外部脚本或网络请求,可离线打开。
局限
样本量仅 12,且为合成演示数据,不能代表总体;角色分组各 4 人,任何组间差异都可能受单条记录影响。问卷没有提供抽样框、置信区间、显著性检验或开放题,因此不能把这些描述性结果解释为真实市场结论。偏好为单选,不能代表完整需求优先级。
下载产物,自己核对
压缩包保存本次执行生成的文件。替换成自己的资料后,可以按下面的检查点验收。
- 样本量 12
- 均值 3.75
- 明确小样本不能代表总体